AI Agent 可以读写文件、执行 Shell、调用编译器,甚至运行来源不明的项目代码。模型能力越强,“如何限制一次代码执行能够看到什么、修改什么、访问什么”就越接近 AI Infra 的基础问题。
虚拟机提供较强隔离,但启动和资源成本较高;完整容器运行时提供镜像、网络、Cgroup 与生命周期管理,但对一次短命令执行可能过重。Bubblewrap(bwrap)选择了更窄的定位:组合 Linux Namespace、Mount、Capability、Seccomp 和进程监管机制,为调用方构造一个临时的文件系统与进程视图。
它不替调用方定义安全策略,也不是一个完整的 OCI Runtime。它更像一个低层沙箱执行器:
1调用方定义策略
2  → Bubblewrap 把策略翻译成 Namespace、Mount 与权限操作
3  → Linux Kernel 执行真正的隔离
4  → Bubblewrap 监管进程并传播退出状态
本文基于 ~/xwork/bubblewrap 的当前源码,重点回答:
- Bubblewrap 与 Docker、runc、systemd-nspawn 的边界是什么?
- 普通用户如何借助 User Namespace 获得“只在命名空间(Namespace)内有效”的管理能力?
- 为什么文件系统构建需要两次
pivot_root? - 为什么简单的 Bind Mount 加只读标记,会扩展成数百行
mountinfo处理? - 外部 Monitor、沙箱 PID 1 与目标程序为什么需要三个进程角色?
- Bubblewrap 已经做了什么,安全策略调用方还必须补充什么?
策略执行器的范围与入口
源码版本与分析范围
以下分析固定在该开发快照,讨论策略落实与进程监管,不等于完成恶意负载安全审计。
| 项目属性 | 当前源码 |
|---|---|
| 本地目录 | ~/xwork/bubblewrap |
| Commit | 0f8073d |
| Git Describe | v0.13.0-4-g0f8073d |
| Meson Version | 0.13.1,v0.13.0(2026-09-22)之后的开发线 |
| Commit 日期 | 2026-09-25 |
.c 实现规模 | 5,640 行 |
| 加上项目头文件 | 约 6,043 行 |
| 必选库依赖 | libcap;内核头文件需提供 __NR_pivot_root |
| 可选库依赖 | libselinux |
| 文件 | 行数 | 主要职责 |
|---|---|---|
bubblewrap.c | 3,568 | 参数解析、Namespace、挂载编排、权限与进程树 |
utils.c | 1,137 | FD、路径、内存、进程与通用系统调用(System Call)封装 |
bind-mount.c | 736 | Bind Mount、mount_setattr、mountinfo 与递归 Remount 回退 |
network.c | 199 | 最小 rtnetlink 客户端与 Loopback 配置 |
safe_openat.c | 333 | openat2/O_PATH 受限路径打开,从 crun 引入 |
2026-10 复核记录
初版分析基点为 2f55bae(2026-06-02,v0.11.2-11-g2f55bae);2026-10 在 0f8073d(2026-09-25,v0.13.0-4-g0f8073d)上复核。两版之间发布了 v0.12.0(2026-08-26)和 v0.13.0(2026-09-22):30 个文件 +2,893/−442,其中 bubblewrap.c +562/−249、bind-mount.c +176/−47、utils.c +69/−17,并新增 safe_openat.c(333 行)。正文已按新快照更新行数与链接,下面只列影响机制判断的差异。
- 安全 Mount 标志有两条落实路径。v0.13.0 起,内核 5.12+ 上
bind_mount_fd()改用mount_setattr(2):对目标目录重新open(O_PATH),然后以AT_EMPTY_PATH | AT_RECURSIVE和MOUNT_ATTR_RDONLY/NODEV/NOSUID一次覆盖整棵子挂载树。只有内核返回ENOSYS时才走原来的mountinfo解析 + 逐 MountMS_REMOUNT回退。其他错误(如EPERM)不会触发回退,而是直接失败;提交 9232fa0 修的就是“非ENOSYS错误也把mount_attr_supported置假”的问题。下文「为什么 Bind Mount 需要七百行代码」已按此改写。 - Setup 阶段新增一次
/procBind Mount。第一次pivot_root之后、setup_newroot()之前,源码把oldroot/proc递归 Bind 到新根的/proc,目的是让后续基于 FD 的mount()调用能使用/proc/self/fd/N。这与用户可见的/proc是两件事:后者仍按 PID Namespace 是否新建走独立 procfs 或宿主 procfs。 - 路径解析改用
openat2的系统调用级约束。safe_openat()从 crun 引入:优先openat2(RESOLVE_IN_ROOT | RESOLVE_NO_MAGICLINKS),不可用时回退到逐段解析;构建时可用-Dassume_kernel=5.6.0把回退编译掉。setup_newroot()中的openat_in_root()通过它访问/oldroot与/newroot,每次重新open根目录,避免--bind / /覆盖/newroot后旧O_PATHFD 看不到新挂载。 - 空路径参数被拒绝。
--bind、--overlay-src、--symlink等接受空字符串时会报does not take an empty path argument(#771);旧版本在部分路径上会把空串当根目录处理。 - 回退与调试可显式触发。
--debug-opt=force-openat-fallback、--debug-opt=force-mount-setattr-fallback用于测试两条回退路径;-Ddebug_logging=true加运行时DEBUG_INVOCATION才输出debug()日志(提交 fd73997、433d2cf)。 - 构建与修复。
pivot_root从运行时可探测改为编译期硬依赖(需要__NR_pivot_root头文件);修复了 remount 失败时resolved_dest的 use-after-free(94d4a48)、旧编译器与 musl 下的构建错误。
没有变的部分:SetupOp 链式结构、双重 pivot_root、resolve_symlinks_in_ops() 在切根前解析、Monitor/PID 1/Target 三角色、signalfd+eventfd 退出码协议、Seccomp 安装在 execvp() 前的顺序,以及 --not-a-security-boundary 仅对 Bind Mount 传入 BIND_FAIL_OPEN 的范围,均与初版一致。
没有跑的验证:本轮没有编译 bubblewrap,没有运行 meson test 或 tests/test-run.sh,也没有在旧内核上实测回退路径;上述结论来自源码阅读、git diff 2f55bae 0f8073d 与 NEWS.md。发行版实际启用的编译选项可能不同,例如 -Dassume_kernel 会把回退能力从二进制中移除。
项目定位与历史
Bubblewrap 的低层定位把资源策略交给调用方,因此可以嵌入不同上层系统,也要求上层承担配置正确性的责任。
从 xdg-app helper 独立出来的低层组件
仓库的第一个 Commit 由 Alexander Larsson 于 2016 年 2 月提交。README 记录了更完整的代码血缘:
1linux-user-chroot
2       ↓
3xdg-app-helper
4       ↓
5Bubblewrap
6       ↓
7Flatpak 等上层调用方
Bubblewrap 最初继承了桌面应用沙箱中的低层能力,随后把应用策略、桌面集成与底层隔离拆开:Bubblewrap 只负责建立沙箱,上层框架负责决定暴露哪些资源。
名字也直接表达了这个定位:bwrap 作为目标应用的父进程“包裹”它,并在外部形成一层保护结构,类似气泡膜 Bubble Wrap。
它和容器运行时有什么不同
现代 Docker/runc 已经支持 Rootless 场景,因此不能简单地把两者区别归纳为“一个非特权、一个只能 Root”。更准确的区别是抽象层次:
| 能力 | Bubblewrap | OCI Runtime / 容器引擎 |
|---|---|---|
| 核心定位 | 单进程沙箱构造器 | 标准容器创建与生命周期 |
| Rootfs | 由 CLI 逐项 Bind/Tmpfs/Overlay 构造 | 通常来自 OCI Bundle/Image |
| Namespace | 直接通过参数组合 | 由 OCI Spec 描述 |
| Cgroup | 不负责资源管理策略 | 通常支持 |
| 网络 | 可隔离到仅 Loopback,不负责完整网络栈 | 常结合 CNI/网络驱动 |
| 镜像 | 不管理 | 通常管理或消费 |
| 生命周期 | 监管一次命令 | 创建、启动、停止、删除容器 |
| 安全策略 | 调用方通过参数定义 | Spec、Runtime 与上层平台共同定义 |
systemd-nspawn 更接近“启动一个轻量系统容器”;Bubblewrap 更接近“为一个进程临时改写世界观”。
两种“安全边界”不能混淆
SECURITY.md 区分了两个问题。
第一,Bubblewrap 不是“当前用户与操作系统之间”的权限边界。普通用户能通过 Bubblewrap 完成的 Namespace 操作,理论上也可以编写自己的程序完成;它不应让用户获得宿主上原本没有的权限。
第二,Bubblewrap 可以成为“被沙箱进程与宿主资源之间”边界的一部分,但强度取决于参数:
1--ro-bind /usr /usr      只读暴露程序文件
2--bind "$HOME" "$HOME"   同时也把用户数据写权限暴露进去
3--share-net              保留宿主网络视图
4--unshare-net            使用隔离网络命名空间
同一个二进制既能构建强约束沙箱,也能只用来调整文件系统布局。安全属性属于“Bubblewrap 能力 + 调用参数 + Kernel + 外部接口”的组合。
整体架构:一条声明式沙箱编译流水线
Bubblewrap 最终只生成一个 bwrap 可执行文件,入口是 main()。整体可以理解为一条小型编译流水线:
 1CLI / FD Arguments
 2      │
 3      ▼
 4parse_args_recurse()
 5      │
 6      ▼
 7SetupOp / LockFile / SeccompProgram
 8      │
 9      ▼
10参数组合与安全前置校验
11      │
12      ▼
13raw_clone(CLONE_NEWNS | ...)
14      │
15      ├── Parent:drop privileges → monitor_child()
16      │
17      └── Child:User/Net Namespace 初始化
18                   │
19                   ▼
20            resolve_symlinks_in_ops()
21                   │
22                   ▼
23          tmpfs + pivot_root #1
24                   │
25                   ▼
26        Bind oldroot/proc → /proc
27             (FD Mount 依赖)
28                   │
29                   ▼
30             setup_newroot()
31                   │
32                   ▼
33             pivot_root #2
34                   │
35                   ▼
36        UserNS/Capability 最终收敛
37                   │
38                   ▼
39       PID 1 Reaper → Seccomp → execvp()
这套流程有两个重要边界:
- 解析阶段不执行挂载。 用户意图先变成数据结构;
- 特权操作完成后不可回头。 旧根被卸载、Capability 被丢弃、Seccomp 被应用,后续阶段只能继续收敛。
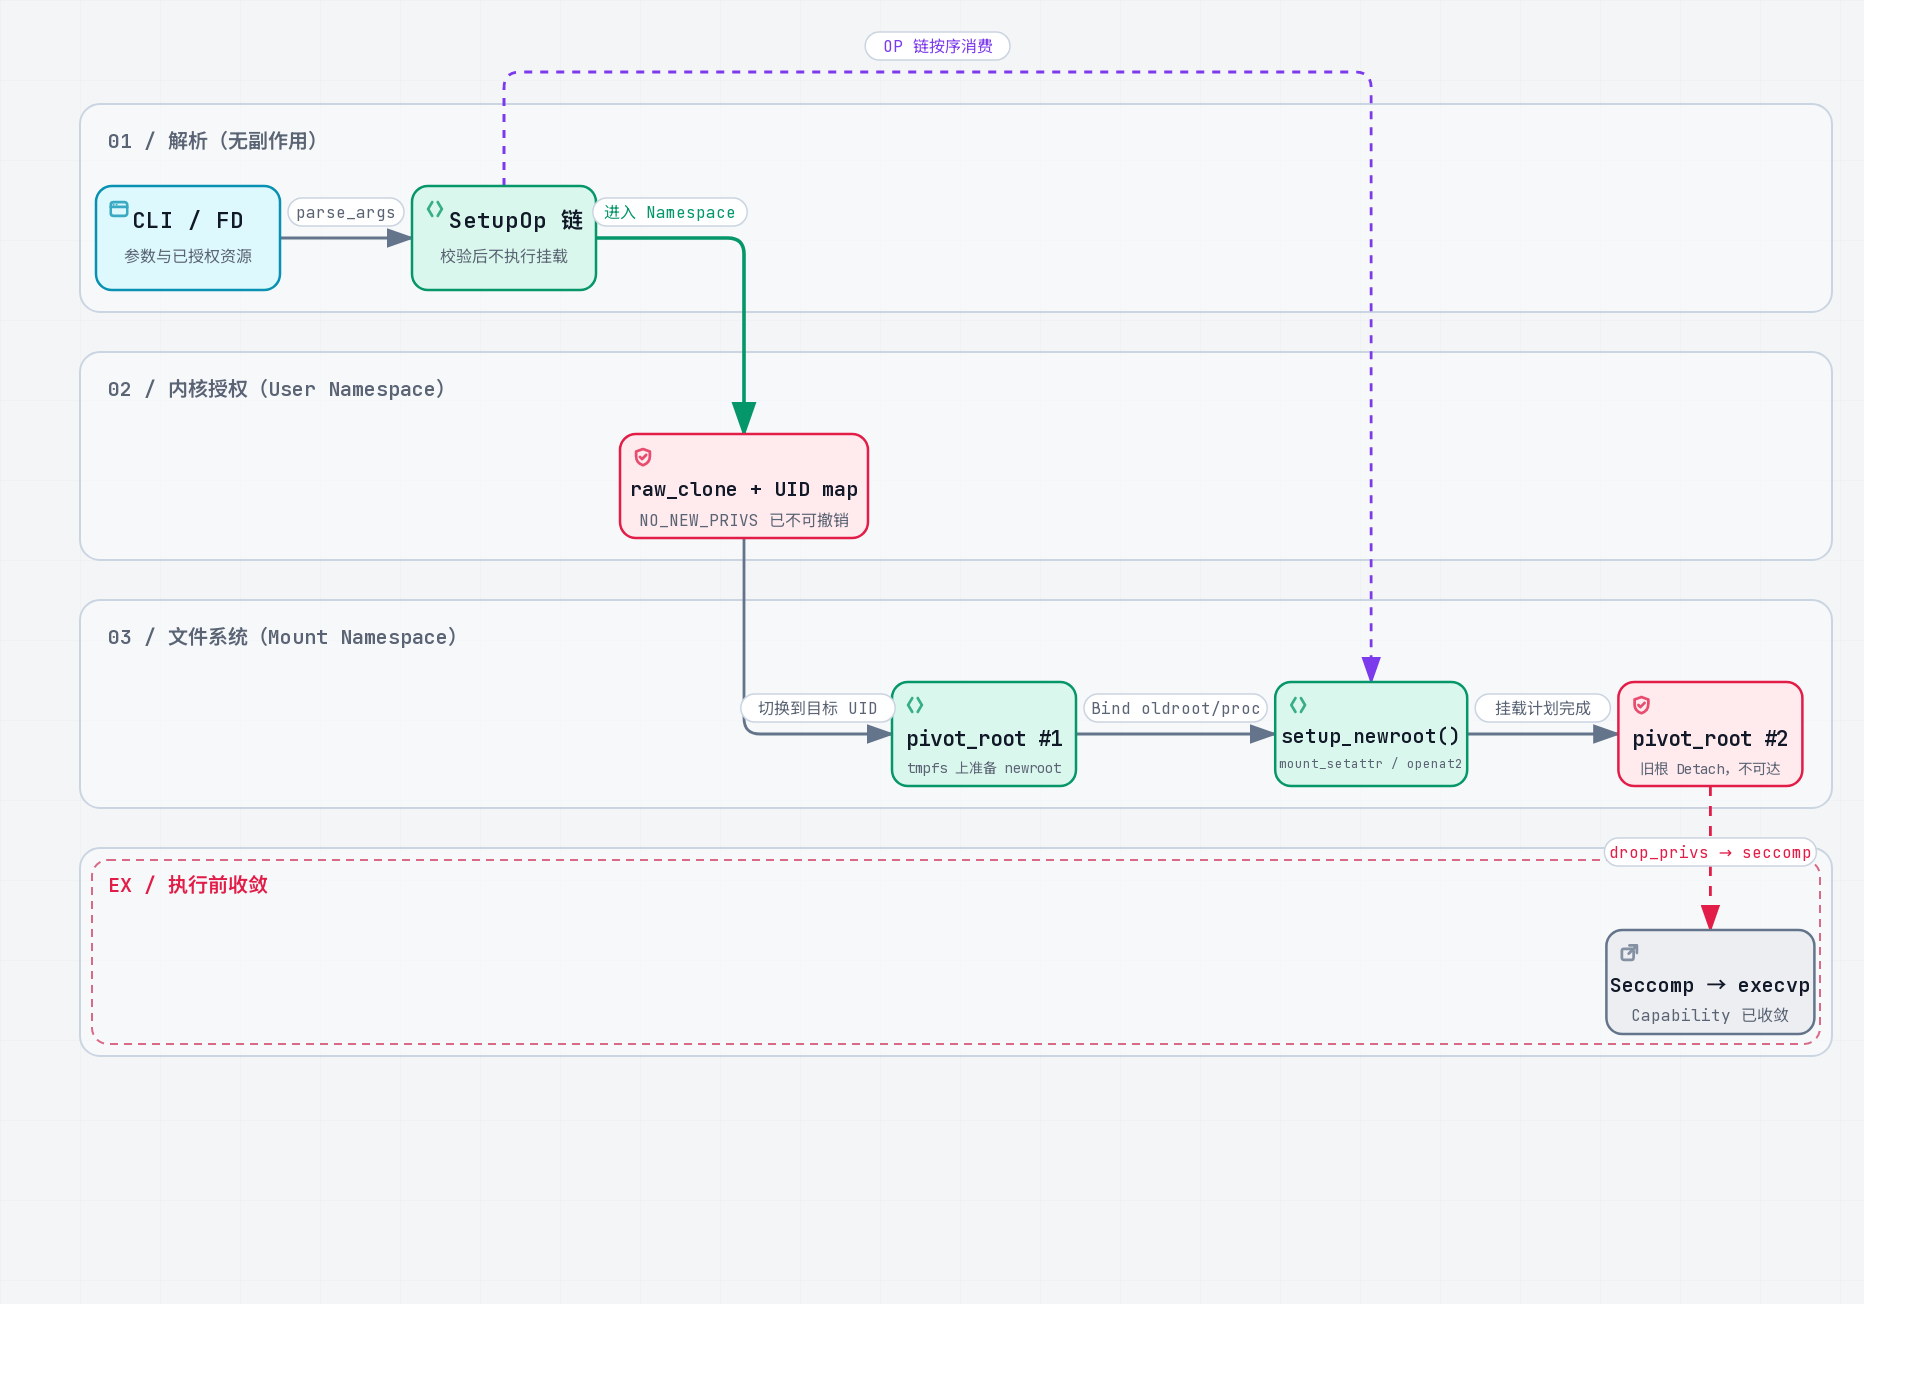
图中把一次调用拆成四段:① 解析(只生成 SetupOp)、② 取得 Namespace 权限与身份映射、③ 构造新根(两次 pivot_root)、④ 收敛权限并 execvp()。红字是源码里无法回退的步骤:PR_SET_NO_NEW_PRIVS、旧根 MNT_DETACH、Capability 丢弃和 Seccomp 安装。图中省略了 mountinfo 树解析、Monitor 的 poll() 循环和 --as-pid-1 分支,这些在对应小节展开。
这张图的可交互版本可以聚焦节点、搜索关系和切换深浅色;下面是它的静态预览。
准备阶段:编译挂载计划,取得局部权限
SetupOp:把命令行编译为挂载计划
参数先转换为有序 SetupOp,再统一执行;这样可以集中校验,但操作顺序本身仍属于策略语义。
数据结构
几十个 CLI 选项最终被归一为 SetupOp:
 1typedef enum {
 2  SETUP_BIND_MOUNT,
 3  SETUP_RO_BIND_MOUNT,
 4  SETUP_DEV_BIND_MOUNT,
 5  SETUP_OVERLAY_MOUNT,
 6  SETUP_MOUNT_PROC,
 7  SETUP_MOUNT_DEV,
 8  SETUP_MOUNT_TMPFS,
 9  SETUP_MAKE_DIR,
10  SETUP_MAKE_FILE,
11  SETUP_MAKE_SYMLINK,
12  SETUP_SET_HOSTNAME,
13  SETUP_CHMOD,
14} SetupOpType;
15
16struct _SetupOp {
17  SetupOpType type;
18  const char *source;
19  const char *dest;
20  int fd;
21  SetupOpFlag flags;
22  int perms;
23  size_t size;
24  SetupOp *next;
25};
它相当于沙箱文件系统的中间表示:
1--ro-bind /usr /usr
2--proc /proc
3--dev /dev
4--tmpfs /tmp
5--symlink usr/lib64 /lib64
6        │
7        ▼
8[RO_BIND] → [PROC] → [DEV] → [TMPFS] → [SYMLINK]
setup_newroot() 在新的 Mount Namespace 中顺序执行链表。操作顺序是用户可观察语义:后一个 Mount 可以覆盖前一个路径,--chmod 也只能作用于已经存在的目标。
解析与执行分离的价值
这种设计带来四个收益:
- 参数语法错误在进入复杂 Namespace 操作前就能失败;
- Source Path 可以统一在切根前解析;
- 特权阶段只消费结构化数据,减少分支与字符串语义;
- 顺序语义天然保存在链表中,不需要额外依赖图。
这与数据库中的“SQL → Logical Plan → Physical Execution”非常相似:先把声明式输入变成中间表示,再在满足前置条件的环境中执行。
修饰符只对下一个操作生效
一次性修饰符限定到后续一个操作,解析器需要在消费后重置状态,否则权限意图会误传给其他挂载。
例如:
1bwrap \
2  --perms 0600 --file 3 /run/secret \
3  --size 67108864 --tmpfs /tmp \
4  ...
解析器使用 next_perms、next_size_arg 与 next_overlay_src_count 保存短暂状态。合法操作消费它们后立即复位;如果下一个参数不匹配,直接报错:
1--perms 必须跟随创建文件的操作
2--size 必须跟随 --tmpfs
3--overlay-src 必须跟随 Overlay 操作
这避免了修饰符作用域模糊,也阻止错误配置被静默接受。
FD 优先于路径
--args、--file、--bind-data 与 --seccomp 都可以从 FD 获取输入。FD 有两个优势:
- 调用方可以在启动前完成打开、权限校验与内容准备;
- 沙箱构建过程中不必重新按路径查找,减少文件被替换的窗口。
--args 允许读取 NUL 分隔参数,并以 MAX_ARGS = 9000 限制递归展开规模,避免恶意输入导致无限解析或整数边界问题。
权限模型:只在必要阶段持有必要能力
构造挂载树需要临时管理能力,运行目标程序则应收敛这些能力;准备阶段与 Exec 阶段的权限必须分开追踪。
入口先永久禁止 Exec 提权
acquire_privs() 首先拒绝历史 Setuid 与意外 File Capability 配置:
1real_uid != effective_uid
2  → 拒绝 Setuid Bubblewrap
3
4非 Root 用户却持有 Capability
5  → 拒绝旧 Setcap 配置
6
7Root 调用
8  → 读取当前 Effective Capability,
9    后续仍可通过 --cap-drop 收敛
随后 main() 立即执行:
1prctl(PR_SET_NO_NEW_PRIVS, 1, 0, 0, 0);
NO_NEW_PRIVS 一旦设置就不能撤销。后续 execve() 即使遇到 Setuid 程序或 File Capability,也不能获得新的权限;非特权 Seccomp Filter 也依赖这一前提。
User Namespace 中的 Root 不是宿主 Root
普通用户运行时,Bubblewrap 会自动启用新的 User Namespace。典型 UID 映射是:
1Sandbox UID 0 ──映射──> Host UID 1000
沙箱内进程看起来是 Root,并拥有这个 User Namespace 管辖资源上的 Capability;但它在父 User Namespace 仍然只是 UID 1000,不能借此修改宿主 Root 拥有的资源。
关键不是“伪造一个 UID 0”,而是 Linux 对权限检查的作用域:
1Capability
2  + User Namespace 所有权
3  + 被操作资源所属 Namespace
4  → 是否允许 Mount/Namespace 管理操作
UID/GID Map 的写入顺序
write_uid_gid_map() 依次处理:
1uid_map
2  → setgroups = deny
3  → gid_map
在无特权写入 gid_map 前必须禁止 setgroups。老内核不存在该接口时,源码只对 ENOENT 做兼容,并明确指出这意味着运行在仍受 CVE-2014-8989 影响的旧内核上。
当第一层 Namespace 需要把真实用户映射成 UID 0,同时又要保留目标 Sandbox UID 映射时,代码还读取 Kernel overflowuid/overflowgid,避免 Namespace 外部无映射文件的属主意外与 Sandbox Root 冲突。
两级 User Namespace 是条件性技巧
草率概括 Bubblewrap 时,经常会说它“总是创建两级 User Namespace”,这并不准确。第二级只在以下情况之一出现:
--dev需要挂载新的 devpts,而第一层必须先把真实 UID/GID 映射成 0;--disable-userns需要在第一层把max_user_namespaces设为 1,再进入第二层固化限制;- 请求的最终 UID/GID 与第一层临时映射不同。
典型 devpts 路径是:
1Host User
2   │
3   ▼
4UserNS #1:real_uid → 0
5   │         用 Namespace Root 完成 devpts 与 Mount Setup
6   ▼
7UserNS #2:0 → sandbox_uid
8             回到最终目标身份
--disable-userns 更进一步:
1UserNS #1
2  → 写 user.max_user_namespaces = 1
3  → 创建 UserNS #2
4  → 沙箱无法回到外层提高限制
5  → 主动调用 unshare(CLONE_NEWUSER)
6  → 如果居然成功,则整体失败
它不是“写完配置就相信”,而是运行时验证安全不变量。
Capability 的三层收敛
Bubblewrap 同时处理:
| 层次 | 作用 |
|---|---|
| Bounding Set | 决定进程及后代未来最多可能获得哪些 Capability |
| Permitted/Effective/Inheritable | 决定当前进程可用与可传递的能力 |
| Ambient Set | 让明确保留的能力跨越非特权 execve() |
创建新 User Namespace 后,Kernel 会重新给予该 Namespace 范围内的 Bounding 能力,因此源码会再次调用 drop_cap_bounding_set()。最终 drop_privs(true) 只保留命令行明确请求的 Capability;普通非 Root 场景默认不保留能力。
构造文件系统:新根、操作顺序与子挂载
Mount Namespace:从空白根目录开始构造世界
新的挂载视图只隔离路径可见性,不会自动隔离已经继承的 FD;构建新根时需要同时处理旧挂载和进程资源。
第一步:阻断反向挂载传播
Bubblewrap 总会创建新的 Mount Namespace,并先执行:
1mount(NULL, "/", MS_SLAVE | MS_REC)
Slave Mount 可以接收上游传播,但当前 Namespace 内的新挂载与卸载不会反向污染宿主挂载树。随后在 /tmp 挂载一个 nodev,nosuid 的 Tmpfs,作为搭建新根的临时工作区。
选择 /tmp 不是为了把它暴露给沙箱,而是因为:
- 路径预期存在;
- 不应是低权限用户可替换的符号链接;
- 完成
pivot_root后不再需要按原路径访问; - Tmpfs 会在最后一个引用退出后自动清理。
两次 pivot_root
完整过程可以画成:
 1宿主视图
 2/
 3└── tmp
 4
 5Mount Namespace 内
 6tmpfs@/tmp
 7├── newroot
 8└── oldroot
 9
10        pivot_root #1
11               │
12               ▼
13/
14├── oldroot   ← 原宿主根,只在 Setup 阶段可见
15└── newroot   ← 根据 SetupOp 构建的新根
16
17        setup_newroot()
18               │
19        oldroot 设为 private
20        umount2(oldroot, MNT_DETACH)
21               │
22        chdir("/newroot")
23        pivot_root(".", ".")
24               │
25               ▼
26/             ← 原 /newroot
27旧搭建根被再次 MNT_DETACH
第一次 Pivot 的价值是同时提供两套稳定前缀:
1/oldroot/usr   → Bind Mount Source
2/newroot/usr   → Sandbox Destination
第二次 Pivot 将 /newroot 提升为真正的 /。pivot_root(".", ".") 看似违反“旧根应位于新根之下”的直觉,但 Kernel 实际检查的是旧根是否能从新根访问;runc 与 LXC 也使用同类技巧。
Source Path 为什么提前解析
resolve_symlinks_in_ops() 在 Chroot/Pivot 完成前、切换回真实 UID 后调用:
- 切根前才能按宿主语义解析绝对 Symlink;
- 使用真实 UID 才能正常访问部分 FUSE Mount;
- 统一解析后,Setup 阶段不需要重新解释用户路径。
对 --bind-fd,源码还在 Mount 后比较 Source FD 与目标的 Device/Inode,检测“解析 /proc/self/fd/N 到真正 Mount”之间的替换竞态。
setup_newroot():顺序执行文件系统计划
同一目标路径上的操作顺序会改变最终可见资源,setup_newroot() 因此必须按计划依次落实并检查失败。
Bind、Tmpfs 与 Overlay
setup_newroot() 逐个消费 SetupOp:
1Bind / Read-only Bind / Device Bind
2Overlay / Temporary Overlay / Read-only Overlay
3Procfs / Devfs / Tmpfs / Mqueue
4Directory / File / Bind Data
5Symlink / Chmod / Hostname
目标父目录会按需要创建。创建敏感文件时,如果目标权限不允许 Group/Other 访问,父目录权限也会同步收紧,避免“文件不可读但父目录意外开放”的惊讶。
Overlay Mount 参数由 StringBuilder 拼装,Source 路径通过 strappend_escape_for_mount_options() 转义逗号、反斜线等控制字符,避免路径被解释成新的 Mount Option。遇到 ELOOP 时还会转换成“Overlay 目录不能重叠”的领域错误。
/proc:共享 PID 与隔离 PID 走不同路径
/proc 暴露的进程视图依赖 PID Namespace,不能在不同进程隔离模式下无条件复用同一挂载处理。
1新 PID Namespace
2  → 挂载新的 procfs
3
4共享 PID Namespace
5  → Bind 宿主 procfs
这层用户可见的 /proc 之外,源码在 pivot_root #1 之后还会把 oldroot/proc 递归 Bind 到新根,供后续基于 FD 的 mount() 使用;setup_newroot() 里显式的 --proc 操作会覆盖或补充这层临时挂载。
无论哪条路径,源码都会检查并只读遮盖:
1/proc/sys
2/proc/sysrq-trigger
3/proc/irq
4/proc/bus
正常非特权用户本来不应拥有危险写权限,这一层属于纵深防御。
/dev:只构建最小设备视图
--dev /dev 不会把整个宿主 /dev 暴露进去,而是:
- 挂载新的 Tmpfs;
- 单独 Bind
null、zero、full、random、urandom、tty; - 创建
/dev/stdin、stdout、stderr等 Symlink; - 使用
newinstance挂载独立 devpts; - 创建
/dev/ptmx与/dev/shm; - 仅当外部 Stdout 已是 TTY 时映射对应
/dev/console。
这体现了 Allowlist 思路:应用需要哪些设备,就明确加入哪些设备。
--bind-data:用匿名化 Mount 承载内容
数据从 FD 复制进 mkstemp 临时文件,随后 Bind Mount 到目标并立即 unlink 临时路径:
1FD Data
2  → Temporary File
3  → Bind Mount to Destination
4  → unlink(Temporary Path)
文件内容仍由 Mount 引用,但沙箱无法从其他路径重新找到临时文件。这种做法把内容生命周期绑定到 Mount,而不是可见文件名。
为什么 Bind Mount 需要七百行代码
只读或 nosuid 要求覆盖实际子挂载,不能只检查顶层路径。Bubblewrap 有两条落实路径:内核 5.12+ 用一次 mount_setattr(2) 递归设置属性;不可用时解析 mountinfo 并逐个 Remount。
主路径:一次 mount_setattr(2)
mount_setattr(2) 接受一个已打开的目录 FD 和属性集合,AT_RECURSIVE 让它作用于整棵子挂载树,正好对应“递归 Bind 之后统一加安全标记”的需求:
11. mount(src, dest, MS_BIND | MS_REC)
22. open(dest, O_PATH | O_CLOEXEC)
33. mount_setattr(fd, "", AT_EMPTY_PATH | AT_RECURSIVE,
4                 attr_set = MOUNT_ATTR_RDONLY | MOUNT_ATTR_NODEV | MOUNT_ATTR_NOSUID)
默认 Bind 强制 nosuid,非 Device Bind 还强制 nodev,只读 Bind 额外加 MOUNT_ATTR_RDONLY。这条路径不需要读取 /proc/self/mountinfo,也不依赖挂载树的遍历顺序。
如果内核没有 mount_setattr(返回 ENOSYS),才进入回退路径;其他错误不会被当成“内核不支持”而静默降级。v0.13.0 的这一选择与 -Dassume_kernel=5.12.0 配套:后者会把回退代码从构建中移除。
回退路径:从 mountinfo 解析到逐个 Remount
Linux Bind Mount 的历史行为是:
1mount(src, dest, MS_BIND | MS_REC)
可以复制挂载关系,却不会可靠地把 MS_RDONLY、MS_NOSUID、MS_NODEV 应用到所有子挂载点。没有 mount_setattr 时,Bubblewrap 采用:
11. 创建 Recursive Bind
22. 读取 /proc/self/mountinfo
33. 找到目标及所有可见子 Mount
44. 保留现有标志
55. 添加 nosuid / nodev / readonly
66. 对每个 Mount 执行 MS_BIND | MS_REMOUNT
parse_mountinfo() 是一个小型树解析器
parse_mountinfo() 的步骤包括:
- 解析 Mount ID、Parent ID、Mount Point 与 VFS Option;
- 反转义
/proc/self/mountinfo的八进制路径; - 用 ID 索引重建 Parent/Child/Sibling 关系;
- 删除被其他 Mount 覆盖、实际不可见的节点;
- 深度优先收集需要 Remount 的 Mount Table。
覆盖检测很重要。Linux 允许多个 Mount 叠在同一路径上;对已经被上层 Mount 遮住的旧节点执行安全操作既没有意义,也可能导致错误判断。
与 Kernel 使用同一份路径字符串
大小写不敏感文件系统可能让 Kernel 在 mountinfo 中记录的路径大小写不同于调用参数。Bubblewrap 不直接用用户字符串匹配,而是:
1open(resolved_dest, O_PATH)
2  → /proc/self/fd/N
3  → readlink()
4  → 使用 Kernel 返回的路径匹配 mountinfo
这是系统编程中非常重要的习惯:遇到 Kernel 视图与用户输入可能不一致时,以 Kernel 已确认的对象身份为准。
--not-a-security-boundary 的精确边界
本文固定提交提供了以下选项;不能据此假定所有发行版都支持:
1--not-a-security-boundary
它不是“关闭安全检查”的总开关。当前实现只把 BIND_FAIL_OPEN 传入 Bind Mount;递归子 Mount 因 Automounter 等原因无法 Remount 时,可以告警并继续。内核支持 mount_setattr 时,这层放宽不会生效:mount_setattr 失败直接返回错误,只有回退路径里的子挂载 Remount 才读取 BIND_FAIL_OPEN。
以下关键失败依然 Fail-Closed:
1创建 Namespace 失败
2pivot_root 失败
3新根构建失败
4Capability Drop 失败
5Seccomp 安装失败
这个选项面向 xdg-dbus-proxy、Steam Runtime 等“只想调整文件系统布局,并不把本次调用视为隔离边界”的场景。如果调用方确实依赖 ro/nodev/nosuid 建立安全边界,就不能启用它。
进入目标进程:监管、网络与权限收敛
进程树:Monitor、PID 1 与目标程序
启用 PID Namespace 且未使用 --as-pid-1 时,典型进程关系是:
1Caller
2  │
3  ▼
4monitor_child()              宿主侧无特权监管进程
5  │
6  └── Sandbox PID 1
7          │
8          └── Target Process(通常是 PID 2)
三个角色职责不同:
| 角色 | 职责 |
|---|---|
| Monitor | 关闭多余 FD、等待状态、向调用方传播退出码 |
| Sandbox PID 1 | 回收所有后代,持有 Lock/Sync FD |
| Target | 应用最终 Capability 与 Seccomp 后 execvp() |
child_wait_fd:父子启动栅栏
raw_clone() 之后,Child 先阻塞读取 child_wait_fd。Parent 完成 Namespace 信息读取、权限丢弃和状态输出后,写入 Eventfd 放行 Child。
这保证了:
- Parent 与 Child 对 UID/GID Map、状态 FD 的操作顺序确定;
- Child 不会在 Parent 尚未完成安全收敛时提前进入 Setup;
- Parent 失败时 Child 不会继续运行不完整沙箱。
event_fd:把 PID 2 的真实退出码交给 Monitor
Sandbox PID 1 必须继续回收其他后代,因此 Target 退出时不能立即退出。它把:
1exit_status + 1
写入 Eventfd,Monitor 读取后减一并返回。加一避免 Eventfd 的零值语义产生歧义。
Monitor 每次 poll() 后先读 Eventfd,再处理 SIGCHLD。因为 Target 退出后 PID 1 也可能很快退出;如果先处理 PID 1 的 SIGCHLD,就可能丢失真正的应用退出码。
signalfd:把信号纳入同步 IO
Monitor 阻塞 SIGCHLD,再通过 signalfd 将其转换为可 Poll 的 FD:
1poll(signalfd, eventfd)
相比异步 Signal Handler,这种设计无需考虑异步信号安全函数,也能在同一事件循环中处理状态通道与子进程退出。
外部 PID Namespace 中的可信 PID
指定 --pidns 时,进入目标 PID Namespace 需要额外 Fork,Monitor 最初拿到的 PID 可能只是中间进程。Bubblewrap 使用带 SO_PASSCRED 的 Unix Socketpair,通过 SCM_CREDENTIALS 把最终 PID 交回 Monitor。
PID 不是普通消息字段,而是 Kernel 随消息附带的 Credential。Monitor 信任 Kernel 认证结果,不信任 Child 自报的数据。
setup_finished_pipe:区分 Setup、Exec 与正常退出
配合 --json-status-fd,Pipe 用字节数编码状态:
10 字节:Setup 尚未完成或状态未知
21 字节:完成 Setup,已进入 Exec 边界
32 字节:Exec 尝试失败
成功 execve() 后,写端因为 O_CLOEXEC 自动关闭。这个小协议让调用方能够区分“应用正常退出”与“沙箱根本没有启动成功”。
Network Namespace:只提供 Loopback
新的 Network Namespace 初始只有 Down 状态的 lo。network.c 没有引入 libnl,而是实现最小 rtnetlink 客户端:
1socket(PF_NETLINK, NETLINK_ROUTE)
2  → RTM_NEWADDR:配置 127.0.0.1/8
3  → RTM_NEWLINK:设置 IFF_UP
4  → 检查 ACK、Sequence 与 Sender PID
Bubblewrap 不创建 Veth、不配置 NAT,也不管理 DNS。需要联网时,调用方要么共享宿主 Network Namespace,要么在外部准备好网络环境再让进程加入。
这再次体现项目边界:提供 Namespace 机制,不扩展成完整网络管理器。
Seccomp 与执行前的最后收敛
系统调用过滤需要在目标执行前安装,但它不替代路径授权、能力丢弃或资源配额;三者控制不同风险。
Seccomp Program 通过 FD 输入
--seccomp 与 --add-seccomp-fd 从 FD 读取 Classic BPF:
1读取全部字节
2  → 长度必须是 8 的倍数
3  → 转换为 struct sock_fprog
4  → 关闭原 FD
FD 输入避免执行临界点再次按路径打开规则文件。多个 Seccomp Program 按链表顺序依次安装。
应用时机尽可能靠近 execvp
目标进程路径中:
1关闭内部 FD
2  → 恢复 SIGCHLD
3  → 设置 PDEATHSIG
4  → 设置 Ambient Capability
5  → seccomp_programs_apply()
6  → execvp()
源码明确要求 Seccomp 成为 Exec 前最后的系统操作之一,这样调用方提供的 Filter 不必允许前面复杂的 Namespace 与 Mount 系统调用。
Sandbox PID 1 也会单独安装 Seccomp,再进入 wait() 循环,避免 Reaper 成为未受限制的旁路进程。
TTY 是容易遗漏的外部接口
如果沙箱与调用者共享终端,恶意进程可能通过 TIOCSTI 向父终端注入字符。Bubblewrap 提供:
1--new-session → setsid()
README 要求:如果 Seccomp 没有禁止 TIOCSTI,通用沙箱应启用 --new-session。CVE-2017-5226 正是“Namespace 已经隔离,但终端控制面(Control Plane)仍然共享”的典型教训。
生命周期绑定
--die-with-parent 使用:
1prctl(PR_SET_PDEATHSIG, SIGKILL);
让 Bubblewrap 或上层调用者退出时,目标进程不会变成失控孤儿。PID 1 持有的 Lock File 与 Sync FD 也利用“进程退出自动关闭 FD”的 Kernel 生命周期完成清理。
调用方仍需承担的安全责任
C 语言工程实践
资源清理和错误传播会影响隔离是否完整建立;提前退出路径与正常路径需要使用同一套所有权约定。
用 Cleanup Attribute 模拟 RAII
utils.h 定义:
1#define cleanup_free __attribute__((cleanup(cleanup_freep)))
2#define cleanup_fd   __attribute__((cleanup(cleanup_fdp)))
使用方式:
1cleanup_free char *path = NULL;
2cleanup_fd int fd = -1;
离开作用域时自动 free 或 close。steal_pointer() 则显式转移所有权并把原指针置空。这让大量多分支系统调用代码不必维护 goto cleanup 阶梯。
错误是类型,不只是字符串
bind_mount() 返回 bind_mount_result,同时用 failing_path 标记具体失败位置。上层再由 die_with_bind_result() 统一决定:
- 是否应该附加
errno; - 是 Source Mount 失败还是 Submount Remount 失败;
- 是否允许
BIND_FAIL_OPEN; - 如何形成可诊断错误。
安全工具不能把“启动失败”都压缩成一个 EPERM。调用方需要知道是 Kernel 不支持 User Namespace、Mount Flag 无法落实,还是文件路径不存在。
默认 Fail-Closed,例外必须显式
大多数系统调用失败都直接 die(),避免在部分完成的安全状态中继续运行。真正允许降级的场景必须同时满足:
1调用方明确声明不依赖安全边界
2  +
3失败类型被实现显式列入可忽略范围
这比“遇到不支持就尽量继续”的兼容性策略更适合安全基础设施。
编译期警告补充实现检查
meson.build 开启了大量严格警告:
1-Werror=shadow
2-Werror=strict-prototypes
3-Werror=implicit-function-declaration
4-Werror=overflow
5-Werror=int-conversion
6-Werror=format-security
7-Wswitch-enum
对 C 系统程序而言,整数转换、格式字符串、隐式声明和枚举漏处理都会直接触及安全边界,把它们升级成构建错误比依赖人工 Review 更可靠。
Bubblewrap 没有替调用方解决什么
Namespace 共享宿主内核,且暴露的资源仍可承载外部权限,所以调用方必须补齐资源限制与威胁模型(Threat Model)。
共享 Kernel
Namespace 隔离的是资源视图,不是 Kernel。Sandbox 仍然共享:
- Linux 系统调用实现;
- Kernel Driver;
- Filesystem 与网络协议栈;
- Kernel 漏洞攻击面。
需要对不可信 Native Code 建立更强边界时,还要评估虚拟机、MicroVM、用户态(User Space) Kernel 或远程隔离执行。
被 Bind 进去的资源就是能力
以下对象一旦暴露,可能绕过“文件系统看起来很干净”的直觉:
| 暴露对象 | 潜在能力 |
|---|---|
| Docker/Containerd Socket | 控制宿主容器 |
| D-Bus Socket | 调用桌面或 systemd 服务 |
| SSH Agent Socket | 使用宿主身份签名 |
| Wayland/X11 Socket | 与桌面会话交互 |
| Writable Home/Workspace | 修改用户代码、配置与凭据 |
/dev 设备 | 进入 Driver 与硬件攻击面 |
| Host Network | 访问内网与本机服务 |
所以安全策略不能只列“禁止路径”,还要把 Socket、FD、Environment、Device 和 Network 当作 Capability。
Seccomp 策略由调用方提供
Bubblewrap 能加载 Seccomp,却不内置一套适用于所有应用的系统调用 Allowlist。编译器、浏览器、数据库、AI Agent 所需系统调用差异很大;错误的通用策略要么无法运行,要么几乎没有限制。
资源限制不属于核心职责
Bubblewrap 不负责完整 Cgroup 策略。CPU、Memory、PID、IO 与执行时间上限需要由 systemd、容器平台或调用方补充。
先写 Threat Model,再拼命令行
Bubblewrap 官方 README 对安全边界的表述非常克制:它负责构造沙箱,保护强度由调用参数决定。换句话说,一条看起来很长的 bwrap 命令并不自动构成威胁模型。用于 AI Agent 时,至少要先写清四类信任关系:
| 对象 | 通常是否可信 | Bubblewrap 能解决什么 | 仍需谁负责 |
|---|---|---|---|
| 被执行代码与依赖 | 不可信 | 限制可见文件、Namespace、Capability 与系统调用 | 调用方定义 Mount、FD、网络和 Seccomp 策略 |
| 策略编译器与启动器 | 可信计算基 | 按参数执行机制 | 产品侧防止参数注入、路径竞态和策略绕过 |
| 宿主 Kernel | 必须信任 | 共享 Kernel,不提供内核隔离 | 及时升级 Kernel;高风险代码使用 MicroVM/VM |
| 同机资源与外部服务 | 部分可信 | 可隔离部分 Namespace | Cgroup、网络代理、凭据代理、配额和审计 |
还应把“机制不可用”与“策略允许降级”分开。某些发行版可能禁用非特权 User Namespace;此时安全执行服务应拒绝任务或切换到经过设计的 VM 后端,不能悄悄退化成普通子进程。--not-a-security-boundary 的名字正是在提醒调用方:只有明确不依赖隔离属性的兼容性场景,才可以接受部分 Fail-Open。
最后,--disable-userns 也不只是一个加固小选项。如果载荷能够继续创建嵌套 User Namespace,它就获得了更大的 Kernel Namespace 攻击面。是否允许嵌套 Namespace 应进入策略,而不是由被执行程序自行决定。这里的判断与项目的 Sandbox security 说明 一致:Bubblewrap 是低层机制,安全模型属于调用它的上层系统。
面向 AI Agent Sandbox 的设计启示
Agent 的命令和仓库内容都可能触发副作用,授权必须在机制层兑现,不能依赖模型自行遵守路径说明。
策略层与机制层分开
策略层决定可访问资源,机制层负责强制执行;将两层分开才能独立检查授权决策与隔离结果。
 1Agent Policy
 2  ├── Workspace 只读/可写范围
 3  ├── 网络域名或完全断网
 4  ├── Secret 与 Environment
 5  ├── 可执行程序
 6  ├── CPU/Memory/Time
 7  └── 审计与用户授权
 8          │
 9          ▼
10Mechanism
11  ├── Bubblewrap Namespace/Mount
12  ├── Seccomp
13  ├── Cgroup
14  ├── Proxy
15  └── VM/MicroVM
Bubblewrap 证明了机制层可以很小;真正复杂的是把用户意图转换成正确策略。
使用 FD 表达已授权资源
如果调用方已经完成路径解析和权限审批,优先传递打开的 FD,而不是让沙箱启动阶段重新解析字符串路径。FD 同时表达:
- 已经选择的 Kernel Object;
- 生命周期;
- 访问模式;
- 跨进程所有权。
Bubblewrap 的 --bind-fd、--args、--seccomp、Eventfd 与 Credential Socket 都体现了这一思路。
不变量必须运行时验证
适合验证的安全不变量包括:
1无法再创建 User Namespace
2旧根已经不可达
3目标 Bind 指向预期 Inode
4Capability Bounding Set 已收敛
5Producer PID 来自 Kernel Credential
6安全 Mount Flag 已递归落实
只写配置、不验证结果,会把 Kernel 版本差异、Mount 传播和竞态问题留给生产环境。
可观测性不能破坏安全性
--info-fd、--json-status-fd 与退出码协议提供结构化状态,但不要求在沙箱内开放额外控制 Socket。Agent Sandbox 同样应优先使用单向 FD、事件流和宿主侧审计,而不是为了调试暴露高权限服务。
用完整调用与故障测试验证边界
一次典型调用的完整时序
以下命令只用于展示组成方式,并不代表适用于任意不可信程序的完整安全策略:
 1bwrap \
 2  --unshare-user \
 3  --unshare-pid \
 4  --unshare-net \
 5  --ro-bind /usr /usr \
 6  --symlink usr/lib /lib \
 7  --symlink usr/lib64 /lib64 \
 8  --proc /proc \
 9  --dev /dev \
10  --tmpfs /tmp \
11  --new-session \
12  --die-with-parent \
13  -- \
14  /usr/bin/bash
源码时序可以归纳为:
 1main()
 2  │
 3  ├── acquire_privs()
 4  ├── PR_SET_NO_NEW_PRIVS
 5  ├── parse_args() → SetupOp
 6  ├── block(SIGCHLD)
 7  ├── eventfd / pipe / socketpair
 8  ├── raw_clone(NEWNS | NEWUSER | NEWPID | NEWNET)
 9  │
10  ├── Parent
11  │     ├── 读取 Namespace ID
12  │     ├── drop_privs(false)
13  │     ├── 输出 Child PID/Namespace
14  │     ├── child_wait_fd 放行
15  │     └── monitor_child()
16  │
17  └── Child
18        ├── 等待 Parent 栅栏
19        ├── UID/GID Map
20        ├── Loopback Setup
21        ├── resolve_symlinks_in_ops()
22        ├── Mount Tree → Slave
23        ├── Tmpfs@/tmp
24        ├── pivot_root #1
25        ├── Bind oldroot/proc → /proc
26        ├── setup_newroot()
27        ├── Detach oldroot
28        ├── pivot_root #2
29        ├── 可选 UserNS #2
30        ├── 验证无法继续创建 UserNS
31        ├── drop_privs(true)
32        ├── setsid()
33        ├── fork()
34        │     ├── PID 1 → do_init()
35        │     └── Target
36        ├── Ambient Capability
37        ├── Seccomp
38        └── execvp()
如何验证这类沙箱实现
Bubblewrap 的 tests/test-run.sh 不只验证“命令能运行”,还覆盖安全不变量:
| 测试方向 | 示例 |
|---|---|
| Namespace | User/PID/Network Namespace 创建与复用 |
| UserNS 禁用 | 沙箱内递归 unshare 必须失败 |
| Capability | Add/Drop 与 PID 1 能力集(Capabilities)合 |
| 生命周期 | --die-with-parent |
| 状态协议 | --info-fd、--json-status-fd |
| Mount | Bind、Readonly、设备、Overlay 与路径转义 |
| Mount 回退 | --debug-opt=force-mount-setattr-fallback;openat2 不可用时走 --debug-opt=force-openat-fallback |
| 参数校验 | 空路径参数必须被拒绝 |
| 数据传递 | --file、--bind-data、FD |
| Seccomp | Allowlist、Denylist、无效 BPF |
| 兼容降级 | --not-a-security-boundary |
安全回归至少应验证:
1Positive:允许的文件、设备与系统调用可用
2Negative:未授权资源确实不可达
3Invariant:旧根、Capability、Namespace 不能恢复
4Lifecycle:父进程退出、Exec 失败、信号退出均能清理
5Race:FD/Path 替换不能切换实际 Mount Source
6Compatibility:Kernel 不支持时明确失败或按策略降级
仅比较 bwrap 退出码不足以证明隔离正确,还需要在沙箱内主动尝试越界操作,并从宿主侧确认没有留下 Mount、进程和 FD。
部署前的验证边界
部署前逐项验证 Mount、FD、Socket、进程回收、Seccomp、Cgroup 与超时,并检查网络、Secret 管理和审计授权。只读根目录不能抵消宿主 Socket 或可写 FD 带来的权限。
若威胁模型包含宿主内核被利用的风险,共享内核的 Namespace 不足以覆盖该风险,应评估 VM 等更强隔离。本文分析 Bubblewrap 的机制,不为任意调用参数或不可信程序提供安全保证。
关键源码阅读索引
| 主题 | 源码入口 |
|---|---|
| 项目定位与限制 | README.md |
| 安全模型 | SECURITY.md |
| 主流程与 SetupOp | bubblewrap.c |
| Bind Mount 与 Mountinfo | bind-mount.c |
| Netlink 与 Loopback | network.c |
| FD、PID 与路径工具 | utils.c |
| Cleanup/Ownership 宏 | utils.h |
| CLI 语义 | bwrap.xml |
| 构建与依赖 | meson.build |
| 主回归测试 | tests/test-run.sh |
| Seccomp 测试 | tests/test-seccomp.py |