这次读 Go 源码,问题最初是“Go 的内存分配相比 malloc/free 做了哪些优化”。沿着分配器往下追,会走到 Linux 的 mmap;再问 runtime 内部系统调用(System Call)为什么与标准库 syscall 不同,就进入了 goroutine 调度器。读到垃圾回收(Garbage Collection,GC)时,这几条路径开始接到一起:分配缓存属于 P,标记工作需要被调度,goroutine 的栈又是 GC 的扫描入口。
我想弄清楚的是:一个 goroutine 创建对象以后,执行、内存管理和回收的成本分别落在哪里,它阻塞以后这些成本又怎样继续存在。 单独记住 mcache、GMP 或三色标记,都不足以回答这个问题。
本文把此前源码讨论与 2026 年 10 月 22 日的本机验证整理到一起。代码阅读覆盖分配、调度、Linux 交互和 GC;实验只验证明确列出的现象,没有重编译整个 Go 工具链,也没有做生产负载的性能评测。
先把版本和证据固定下来
本机源码和执行工具均来自 /home/lism/work/go,避免 PATH 上的另一个 go 混入实验。
1cd /home/lism/work/go
2cat VERSION
3./bin/go version
4./bin/go env GOROOT GOOS GOARCH GOEXPERIMENT
5uname -srmo
| 项目 | 本次状态 |
|---|---|
源码 VERSION | go1.26.2,附带时间 2026-03-27T21:58:29Z |
| 执行工具 | go version go1.26.2 linux/amd64 |
| GOROOT | /home/lism/work/go |
| Linux | 6.6.87.2-microsoft-standard-WSL2,x86_64 |
| GOEXPERIMENT | 环境输出为空,使用平台基线配置 |
| GC/对象保留实验 | GOMAXPROCS=2,GOMEMLIMIT=off |
| syscall 实验 | GOMAXPROCS=1,reader 使用 LockOSThread |
这里有一个需要修正旧笔记的地方:Go 1.26.2 默认启用 Green Tea GC。 src/internal/buildcfg/exp.go 的 baseline 直接设置了 GreenTeaGC: true,因此 go env GOEXPERIMENT 为空并不表示它关闭。这个状态也与 Go 1.26 发布说明一致。不能因为文件上还有 goexperiment.greenteagc 构建条件,就把当前默认路径当作未启用的实验。
本地目录不能正常提供 Git 提交信息,因此我没有为它虚构 HEAD。为核对关键实现,将本机 proc.go、mgc.go、mgcpacer.go、mgcmark_greenteagc.go 的 SHA-256 与上游 go1.26.2 同名文件逐一比较,四者一致。下文公开源码链接固定到这个 tag;完整哈希保存在实验说明中。
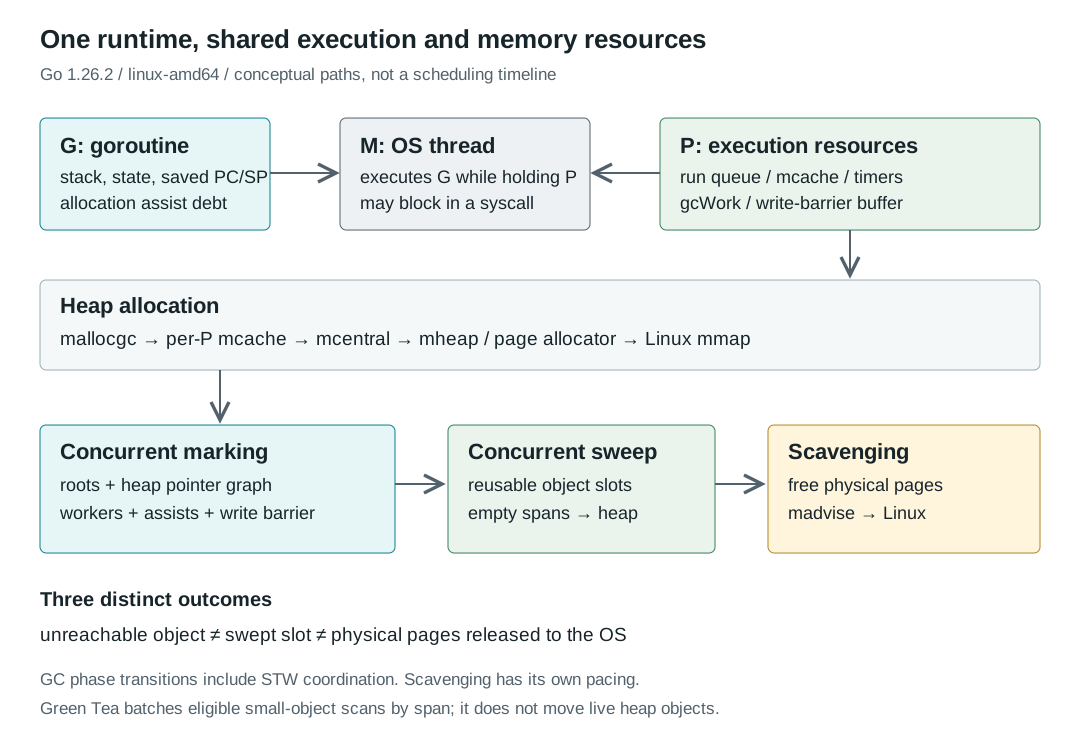
图中是几条机制的连接关系。并发标记(Concurrent Marking)与并发清扫(Concurrent Sweeping)属于不同阶段,阶段切换还需要全局暂停(Stop-The-World,STW)协调;页回收器(Scavenger)有自己的节奏。
从一次堆分配看 P 为什么重要
对象是否进入堆,首先是编译器的问题。逃逸分析(Escape Analysis)决定哪些对象必须跨越当前栈帧存活;随后编译器还可能进行内联、分配消除等优化。不能仅凭源码写了 new(T),就断言一定调用堆分配器。
对进入堆的常规路径,可以从 walk/builtin.go、runtime.newobject 和 runtime.makeslice 追到 mallocgc。接下来有几个决定性的分支:
1需要堆存储的对象
2  → mallocgc:大小、类型是否包含指针、是否需要清零
3  → tiny / small noscan / small scan / large
4
5小对象:当前 P 的 mcache → 对应 span 中的空闲 slot
6缓存不足:mcentral.cacheSpan → 必要时清扫 → mheap
7大对象:mheap 分配 span
8页不足:堆扩容 → Linux 映射接口
mspan 描述一段连续的 runtime 页,小对象按大小类别(Size Class)分配到固定尺寸的 slot。mcache 保存当前 P 可用的 span;mcentral 按 span class 管理共享 span 集合;mheap 再管理页与全局堆。noscan 表示对象内部没有需要继续追踪的 Go 指针,并不表示这个对象免于 GC。小于 16 字节且不含指针的对象还可能通过 tiny allocator 共用一个小块。具体入口见 malloc.go、mcache.go 和 mcentral.go。
这里的快速路径依赖一个所有权条件:当前 M 执行普通 Go 代码时持有 P,分配器在访问这些本地状态的关键区间也会限制抢占。同一个 P 的本地缓存不需要同时服务多个正在执行 Go 代码的 M,所以常见的小对象分配可以避开全局堆锁。这不意味着所有分配无锁。span refill、页分配、GC 协调及向操作系统申请内存仍可能进入更重的路径。
这也解释了为什么缓存没有绑定到 G。goroutine 数量可以很多,并且能够迁移;按 P 保存缓存,使主要本地资源随 Go 执行并行度扩展。GOMAXPROCS 控制 P 的数量,不控制 goroutine 或系统线程的总数。
此前拿 Go 与 malloc/free 对比时,有两点需要收紧。第一,malloc/free 通常是用户态 C 分配器接口,并非 Linux 的同名系统调用;成熟 C 分配器同样会缓存小对象、批量申请页,不能默认每个 malloc 都进内核。第二,Go 的机制优势来自编译器、类型信息、调度器和 GC 的配合,是否更快仍取决于对象大小、寿命、指针结构和负载,不能从调用层次直接得出性能排名。
G、M、P 如何让执行继续下去
runtime2.go 中的 G、M、P 分别保存任务状态、线程状态和执行资源。这里的 P 是逻辑执行资源,不是物理 CPU,也不是内核进程。
| 对象 | 主要持有的状态 | 对本文问题的影响 |
|---|---|---|
| G | goroutine 栈、保存的执行现场、运行状态、等待原因、assist 债务 | 阻塞时仍可持有堆指针,分配时可能承担标记工作 |
| M | OS 线程、g0、当前 G、当前或原来的 P | 真正执行指令,也可能阻塞在内核中 |
| P | 本地运行队列、mcache、timers、gcWork、写屏障缓冲区 | 把分配、调度和 GC 的本地资源连接起来 |
go f() 进入 newproc/newproc1 后,runtime 创建或复用 G,初始化栈与启动现场,再让它进入可运行状态。调度器找到它后,execute 设置 G/M 关系,将状态从 _Grunnable 转为 _Grunning,通过 gogo 恢复执行现场。相关实现集中在 proc.go。
goroutine 阻塞在 channel 时,常见路径是 gopark → park_m → schedule。G 进入 _Gwaiting,当前 M 可以继续执行其他 G。唤醒侧的 goready/ready 只把它变回可运行状态并安排入队,后续还需要获得执行机会;“唤醒”不承诺马上执行。
channel 用 sudog 表达 G 与等待对象之间的关系。阻塞发送会把等待节点放入 sendq,接收侧完成数据传递后再唤醒发送方;反向等待则使用 recvq。select 还允许一个 G 参与多个等待关系。这些操作受 channel 锁和调度协议约束,源码还要处理关闭、非阻塞操作及栈移动,不能简化成任意两条“入队、解锁”语句。见 chan.go。
调度选择也不能背成一张固定优先级表。当前 findRunnable 在本地队列之前就会处理 STW 协调、timer、trace reader,并尝试选择 GC worker;还会周期性检查全局队列以保持公平。后面才继续检查本地/全局任务、网络事件、工作窃取(Work Stealing)和空闲路径。runnext 是本地队列机制的一部分。GC worker 从调度器取得 CPU,本来就处于应用执行路径之中。
Linux 上的网络等待还可以经过网络轮询器(Network Poller)。符合条件的非阻塞 socket 在操作返回 EAGAIN 后,让 G 等待 poller;epoll 就绪再使它可运行。它与线程阻塞在普通 read syscall 是两条路径,不能把所有 I/O 都说成“让 M 阻塞,然后摘走 P”。对应实现见 netpoll.go 和 netpoll_epoll.go。
阻塞 syscall 时,P 到底怎样交接
标准库 syscall.Syscall 将内核调用包在调度通知之间:
1runtime.entersyscall
2  → RawSyscall6 → internal/runtime/syscall/linux.Syscall6 → SYSCALL
3runtime.exitsyscall
普通 RawSyscall 本身不发出这组进入/退出通知。因此,“最终都使用 SYSCALL 指令”只能说明共享内核 ABI,不能说明具有相同的调度行为。
在这份 Go 1.26.2 源码中,普通 entersyscall 经 reentersyscall 保存 PC/SP/BP,记录 m.oldp,并把 G 从 _Grunning 转为 _Gsyscall。普通路径允许 M 暂时保留 P,以便短 syscall 返回后继续执行。 当有待处理的 STW 等情况时,也可以在这里提前交出 P。
如果 syscall 没有及时返回,系统监控线程 sysmon 中的 retake 会检查运行中的 P,尝试通过 setBlockOnExitSyscall 获取稳定的 G/M/P 关系。确认可以回收后,thread.takeP() 解除原线程的 P 关系,handoffp 再安排后续使用。该版本甚至可能在 P 仍为 _Prunning 时发现对应 G 正处于 _Gsyscall;套用其他版本中“进入 syscall 一定把 P 设为 _Psyscall”的流程,会读错这里的协议。
交接不是精确的固定超时承诺。retake 会结合监控 tick、P 上的任务、空闲 P 和自旋 M 等状态判断。明确已知会阻塞的 entersyscallblock 则会立即执行交接。返回侧 exitsyscall 必须确认当前线程仍持有或能重新取得 P;取不到时,G 需要回到可运行队列,之后再继续执行普通 Go 代码。
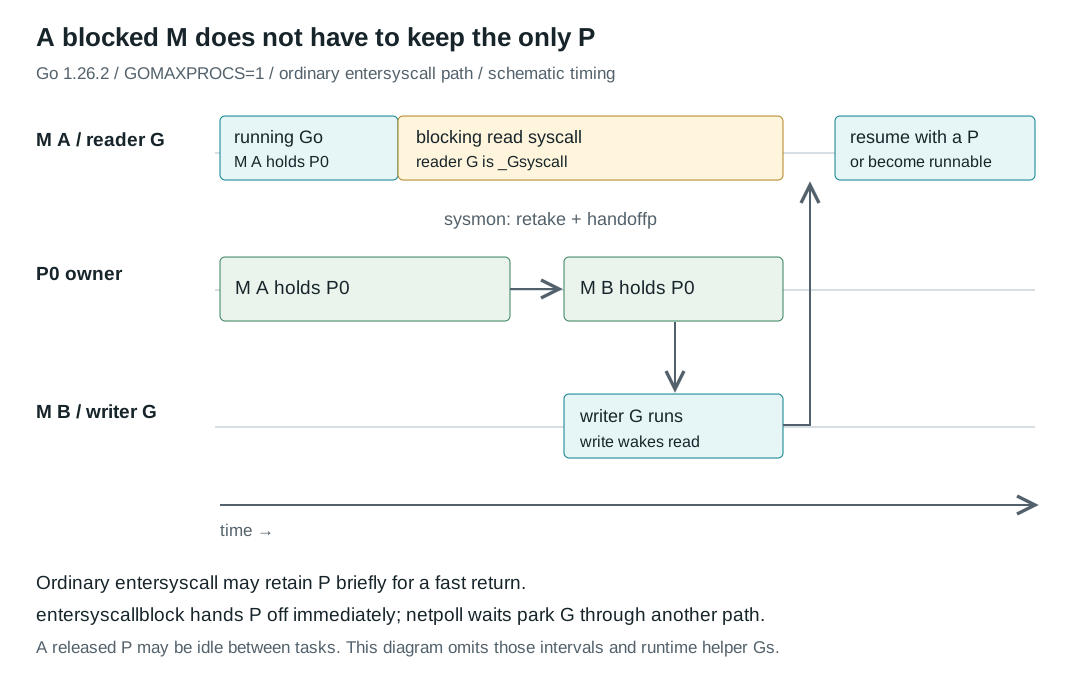
这也是 runtime 内部低层接口与标准库接口不能完全统一的原因。runtime 的内存映射、线程创建、信号处理、futex 等路径可能处于没有 P、持有内部锁、不能增长栈的上下文。它们需要各自符合调用环境的封装;这不意味着所有 runtime syscall 都具有同一种阻塞或调度语义。
之前读到的 cgo_mmap.go 正是一个具体例子:_cgo_mmap 存在时,通过 C 包装让相关拦截器参与;否则进入 sysMmap。Linux/amd64 的低层汇编实现位于 sys_linux_amd64.s。
单 P 的阻塞调用实验
实验程序使用 syscall.Pipe2 创建阻塞管道,reader 锁定当前 OS 线程,另一个 goroutine 等待 100 ms 后写入一个字节。这里刻意使用裸文件描述符与 syscall.Read,让观察目标落在 syscall 调度通知,而不是 os.File 可能参与的 netpoll 路径。
完整源码保存在站点的 main.go。先编译,再运行;不使用 go run,以免编译器进程的日志与目标程序混在一起。
1GO=/home/lism/work/go/bin/go
2LAB=/home/lism/work/lishuming.github.io/static/code/go-runtime-lab
3"$GO" build -o /tmp/go-runtime-lab "$LAB/main.go"
4GOMAXPROCS=1 GOGC=100 GOMEMLIMIT=off /tmp/go-runtime-lab \
5  -mode syscall -trace /tmp/go-runtime-syscall.trace
6"$GO" tool trace -d=parsed /tmp/go-runtime-syscall.trace
本次输出如下,TID 与耗时只是这次运行的记录:
1reader tid=13860 gomaxprocs=1
2writer tid=13858 after=103ms
3reader resumed tid=13860 after=103ms byte=42
trace 进一步给出了 reader 的 Running → Syscall,P0 随后从原执行关系转出并在另一 M 上运行,writer G 获得执行机会;reader 返回时出现 Syscall → Runnable → Running。状态迁移摘录保留了 reader、writer 和 P0 的相关事件。这比仅看到两条打印更能支持 P 交接的解释。
这个实验说明,一个被锁定、阻塞在内核里的线程,并不必然占住唯一的 P。它没有测量普遍的 syscall handoff 延迟,也没有证明任意阻塞 I/O 都走相同路径。trace 本身还会增加辅助 goroutine 与观测开销。
GC 怎样在这些执行资源上完成回收
mgc.go 对当前收集器的定义仍然是并发、非分代(Non-Generational)、非压缩(Non-Compacting)的标记清扫(Mark-Sweep)。Green Tea 改进了标记扫描的组织方式,存活堆对象仍不会为了压缩而搬迁。goroutine 栈可以增长和复制,因此“堆对象不移动”不能扩大成“Go 的所有地址永远不变”。
典型 GC 循环可以沿 gcStart → gcMarkDone → gcMarkTermination 阅读,其关键是各阶段的所有权与正确性条件:
| 阶段 | 关键动作 | 为什么需要它 |
|---|---|---|
| sweep termination / STW | 确认上一轮剩余清扫,协调 P 到安全点 | 不能让旧 span 状态与新标记周期混用 |
| 启动 mark / STW | 设置 _GCmark,启用写屏障与 assist,准备根扫描任务 | 必须先让所有 P 看到屏障状态,再允许并发扫描 |
| 并发 mark | 扫描根和对象图,worker 与分配者协作 | 应用继续修改对象时仍要保存可达性证据 |
| mark termination / STW | 确认工作完成,切换 _GCmarktermination,处理周期收尾 | 本地缓存、屏障缓冲与全局工作都不能遗漏 |
sweep / _GCoff | 关闭标记期屏障,并发清扫 span | 让不可达对象占用的 slot 和空 span 重新可用 |
gcMarkDone 不能只凭某个 worker 发现队列为空就宣布结束。它需要协调各 P 刷新写屏障缓冲与本地工作,再检查是否生成了新任务;进入 STW 后若仍发现残留工作,还可能重新启动并发标记。这条返回路径说明,完成判定是分布式工作状态的协议,不是一次全局队列长度判断。
根集合(Root Set)包括 goroutine 栈中的活跃指针、全局变量中的相关指针,以及 runtime 在堆外保存的部分引用。扫描栈需要取得对应 G 的扫描权限并在安全状态下读取,不能与它任意修改同一栈帧并行。编译器提供的栈图与类型信息,使常规路径知道哪些位置是指针;preempt.go 也明确描述了异步抢占现场的保守扫描例外,因此“精确 GC”不应被解释为任何执行现场都不存在保守处理。
安全点(Safe Point)将调度与 GC 进一步连起来。同步抢占利用函数序言的栈检查;异步抢占(Asynchronous Preemption)在 Linux 上借助信号检查执行现场,满足条件后再安排进入抢占处理。runtime 不能在任意指令处无条件停住一个 G 并开始移动其栈。见 preempt.go。
混合写屏障保存并发修改中的可达性
用三色标记(Tri-Color Marking)的抽象描述对象:白色表示尚未发现,灰色表示已发现但引用还没处理完,黑色表示相关扫描已经完成。颜色主要是对状态的解释,实际状态存在 bitmap、工作队列和扫描元数据中。
并发执行的应用可能把某个对象的最后一条引用从一个位置移动到另一个位置。如果 GC 已经扫过目的位置,又没赶上来源位置的变化,就可能漏掉仍在使用的对象。写屏障(Write Barrier)要维护的正是这个并发不变量。
mbarrier.go 给出的混合写屏障(Hybrid Write Barrier)结合了删除与插入两种保护:覆盖旧引用前保护旧对象,在当前栈尚未扫描完成时还要保护写入的新对象。理论描述中的第二项带有栈颜色条件,当前实现则为减少条件判断与同步复杂度,对新旧引用采用更保守的记录方式。缓冲记录之后还要由 mwbbuf.go 等路径刷入标记工作。
标记期新分配对象会直接按黑色处理,避免刚创建、正在使用的对象被本轮回收。这允许本轮留下部分随后变得不可达的对象,等后续周期再处理。GC 的正确性首先要求不漏掉仍可达对象,并不承诺某个对象失去引用后的瞬间就归还内存。
Green Tea 保持对象图语义,调整扫描的局部性
传统的理解是“发现对象,排入对象工作队列,再逐个扫描”。当前源码还需要加入 span 级路径。Green Tea 对符合条件的小对象延迟扫描,让同一 span 内更多已发现对象聚集后一起处理,改善缓存局部性(Cache Locality)与元数据访问。这个动机也见于 Green Tea 的官方介绍。
mgcmark_greenteagc.go 中,spanInlineMarkBits 同时记录 marks 与 scans,分别表示对象已被发现、已经扫描。scanSpan 使用 marks &^ scans 找到待扫描对象,并处理 span 的并发所有权、重复入队与新标记。源码还有只有一个待处理对象时的快速路径。常规对象工作队列依然存在,大对象等情况也有其他处理路径,不能把整个 GC 写成“一律按 span 扫描”。
两套位图也不是把“分配位图”改名为“扫描位图”。mspan.allocBits、标记状态、Green Tea 的扫描状态各有职责;清扫前还要按当前实现合并相关标记信息。阅读这个版本时,需要同时看 mgcwork.go、gcDrain 和 scanSpan,才能解释工作怎样进入和离开队列。
本次没有关闭 Green Tea 做对照 benchmark,因此这里不引用任何加速百分比作为本机结论。观察到某条扫描路径存在,也不能推导出当前 CPU 一定执行了某条向量指令。
GC 何时启动,分配者为什么还要帮忙
节奏控制器(Pacer)需要同时考虑分配速度、待扫描工作和标记进度。它既要安排启动时机,也要决定应用与 GC 怎样分享有限的 P。源码入口是 mgcpacer.go。
先修正一个过于简略的表述:“GOGC=100,live heap 为 4 MiB,因此到 8 MiB 开始 GC。”这里同时省略了根扫描成本,也混淆了目标和启动阈值。commit 中的基础计算可写成:
1gcPercentHeapGoal = heapMarked
2  + (heapMarked + lastStackScan + globalsScan) × GOGC / 100
也就是在上一轮存活堆之外,为堆与根相关的扫描工作留出增长空间。heap goal 是希望本轮标记完成时接近的堆目标;trigger 是为了给并发标记留出时间而计算的启动阈值。 两者不是同一个值。实际目标还会受最小堆、清扫距离、最小 runway 和内存限制等条件调整。根成本进入公式这一点,也与 Go GC Guide 的说明一致。
若分配仍在迅速推进,后台 worker 可能赶不上。分配者协助(Mutator Assist)把一部分工作交回分配 goroutine:分配路径扣减 gcAssistBytes,债务变负时进入 gcAssistAlloc,根据当前比例完成一定扫描工作;必要时也会等待其他标记进展。入口在 malloc.go 与 mgcmark.go。
这使“暂停时间很短”与“请求几乎没受 GC 影响”成为两个不同命题。业务 goroutine 可以在没有全局暂停的情况下,因 assist 增加分配延迟;后台 worker 也会占用 CPU 和缓存。排查延迟时应把 STW、assist、调度等待与扫描工作结合起来看。
GOMEMLIMIT 又给出了另一个约束。runtime 会用它计算可能更小的目标,但它是软限制(Soft Memory Limit),不是容器 RSS 的硬边界,也不涵盖进程里所有外部内存。其核算可近似从 MemStats.Sys - HeapReleased 理解。设置得过低会增加 GC 压力,runtime 仍可能超过限制;GOGC=off 也不自动关闭内存限制驱动的回收。这里的本机实验统一使用 GOMEMLIMIT=off,没有验证软限制下的行为。
同等容量的扫描成本实验
实验程序每轮创建约 2 MiB 数据,共 64 轮,环形数组保留最后 8 轮,因此主要工作负载累计申请约 128 MiB,最终保留约 16 MiB。提供两种布局:
bytes:每轮一个[]bytebacking array,数组内容不含指针。nodes:每轮 32768 个 64 字节链表节点,每个节点包含一个next *node和 56 字节数据。
这控制了主要容量,没有控制分配次数、对象图拓扑和写入工作,不能作为严格的吞吐量对比。两者的用途是显示“保留多少字节”与“有多少可扫描指针区域”之间的差别。
程序先强制一次 GC 建立 baseline,完成负载后再强制一次 GC,读取 retained 快照;之后撤销引用并再次回收,最后通过 debug.FreeOSMemory 观察页归还。runtime.KeepAlive 将保留对象的存活区间明确延续到 retained 快照之后,防止编译器提前判定其已不再使用。
1GOMAXPROCS=2 GOGC=100 GOMEMLIMIT=off GODEBUG=gctrace=1 \
2  /tmp/go-runtime-lab -mode gc -kind bytes
3GOMAXPROCS=2 GOGC=100 GOMEMLIMIT=off GODEBUG=gctrace=1 \
4  /tmp/go-runtime-lab -mode gc -kind nodes
以下均为 retained 阶段的单次本机结果,MiB 按 2 的 20 次方字节计算:
| 布局 | HeapAlloc / MiB | 可扫描堆 / MiB | 自动 GC 次数 | 累计 mark assist CPU / ms |
|---|---|---|---|---|
| bytes | 16.090 | 0.061 | 9 | 0.308 |
| nodes | 16.090 | 2.061 | 8 | 16.833 |
“可扫描堆”取自 /gc/scan/heap:bytes,它描述当前可扫描堆空间,并非历次扫描量的总和。64 字节节点只有前面的指针区域需要参与相关扫描,不能把整块 16 MiB 都当作指针。bytes 的外层 slice、程序对象与 runtime 仍包含引用,所以它的指标也不会归零。各指标定义见 runtime/metrics/description.go。
在这次记录里,指针链对应的 assist 时间明显更大;但 bytes 的自动周期数还略多一次。分配速度、图结构与并发标记进度一起决定周期,这正好提醒我不要把“扫描更少”直接写成“周期数必然更少”。这些毫秒值受 WSL 负载和观测开销影响,没有重复采样,不作延迟分位数或通用性能保证。
对同一 nodes 负载改变 GOGC,本次得到:
| GOGC | 自动 GC 次数 | retained 时 NextGC / MiB | 累计 mark assist CPU / ms |
|---|---|---|---|
| 50 | 17 | 24.213 | 78.181 |
| 100 | 8 | 32.335 | 16.833 |
| 200 | 4 | 48.580 | 5.106 |
三个进程的最终保留容量相同。增加 GOGC 后,允许的堆增长空间更大,本次观察到自动周期和 assist 都减少。这里的 NextGC 来自最后一次强制 GC 后的状态,并非整个运行期间固定不变的阈值。表格也没有记录运行期间峰值堆或 RSS,不能拿它代替内存预算测量。
从 nodes 原始 gctrace 摘取一轮:
1gc 4 @0.027s 16%: 0.080+14+0.12 ms clock, 0.16+1.7/8.2/9.7+0.24 ms cpu,
215->19->19 MB, 18 MB goal, 0 MB stacks, 0 MB globals, 2 P
这里只为排版换行,三个 wall-clock 数值对应 sweep termination、并发 mark 与 mark termination;中间的 14 ms 不能读成一次 14 ms STW。CPU 项再区分 assist、后台标记和 idle 标记等时间。15->19->19 MB 表示启动、标记结束与标记后存活量的整数 MB 输出,18 MB goal 也不是不可超出的上限。栈与全局项显示 0 MB 则是取整,不能据此断言没有根扫描。
对象释放以后,为什么内存还留在进程里
标记判断可达性,清扫把未标记对象的 slot 变成可复用空间。整块 span 没有存活对象时,页可以回到 runtime 的堆分配器;物理页什么时候交回 Linux,还要经过 scavenger。对内存曲线的解释必须区分这些阶段。
mgcsweep.go 区分 object reclaimer 与 span reclaimer:前者寻找 span 内未标记的 slot,后者主要寻找能整体释放的 span,两条路径最终都会调用 span 清扫逻辑。清扫既可以由后台推进,也可能在分配需要补充 span 时同步执行。因此分配慢路径除了 assist,还可能承担清扫成本。
sweepgen 用代数表达 span 的清扫状态。对于常规状态,h.sweepgen - 2 表示待清扫,h.sweepgen - 1 表示正在清扫,等于 h.sweepgen 表示清扫完成;缓存中的 span 还有 +1、+3 等状态,不能只记两种值后忽略缓存协议。详见 mheap.go 的 mspan 注释。这个协议让并发分配和清扫知道谁拥有 span,避免把上一周期的标记位当作新分配状态使用。
空闲页之后由 mgcscavenge.go 等路径推进归还;Linux 侧 mem_linux.go 的 sysUnusedOS 使用 madvise 等机制处理物理页。地址映射可以继续保留以供以后复用,所以这也不等于每次都 munmap。
非压缩设计也留下了使用边界:某个 span 即使已经有很多空闲 slot,只要仍有存活对象,整块 span 就不能直接作为空 span 释放。大小类别允许后续同类对象复用这些位置,但 GC 不会搬走剩余对象来保证把所有碎片合并。因此,少量长期存活对象与大量短命对象混在一起时,仍可能保留额外空间。
前面 nodes、GOGC=100 实验的后续快照为:
| 阶段 | HeapAlloc / MiB | HeapIdle / MiB | HeapReleased / MiB |
|---|---|---|---|
| retained | 16.090 | 34.828 | 3.945 |
| 撤销引用并 GC | 0.091 | 51.352 | 7.773 |
debug.FreeOSMemory 后 | 0.091 | 51.352 | 51.156 |
对象空间已明显下降时,runtime 仍持有很多可复用的空闲页;主动触发页回收后,released 指标才进一步上升。HeapReleased 是 HeapIdle 的子集,不能把这两列相加。这个实验记录的是 runtime 统计,没有采样 /proc 的 RSS,所以不把表格解释成物理驻留量实测。
debug.FreeOSMemory 是为了放大观察对象回收与页归还的区别,不是建议在每个请求后强制使用。实际运行时还有后台 scavenger 与同步回收路径,它们会按自己的目标推进。
等待中的 goroutine 保留什么
goroutine 被 park 后不再占用一个持续执行的 M,但其栈与等待状态仍然存在。只要栈上还有活跃指针,被引用的堆对象就仍可能可达。因此 goroutine 泄漏(Goroutine Leak)既可能是任务数量问题,也可能放大为堆内存保留问题。
第三组实验启动 2000 个 goroutine,每个分配一个 16 KiB 的 []byte,在同一个 channel 上等待释放。KeepAlive(payload) 放在接收之后,使等待期间必须保持 payload 可用。主 goroutine 确认分配完成后读取快照,再关闭 channel、等待全部结束并回收。
1GOMAXPROCS=2 GOGC=100 GOMEMLIMIT=off \
2  /tmp/go-runtime-lab -mode roots -goroutines 2000 -payload 16384
| 阶段 | goroutine 数 | HeapAlloc / MiB | 上轮扫描栈 / MiB |
|---|---|---|---|
| baseline | 1 | 0.080 | 0.002 |
| 等待释放 | 2001 | 32.487 | 0.734 |
| 全部 join 并 GC | 1 | 1.046 | 0.002 |
2000 × 16 KiB 的 payload 自身就是 31.25 MiB,等待阶段的额外占用还包含 G、等待节点等对象。结束后也不会恰好回到 baseline,runtime 可以保留和复用部分结构。/gc/scan/stack:bytes 表示上轮实际扫描的栈空间,不能拿它当作所有 goroutine 栈的已分配总量。
这组结果把前面的几条关系接上了:G 虽然不再执行,栈上的引用仍把 payload 留在对象图中;更多栈扫描也进入 pacer 的成本估计。GC 无法代替应用结束一个仍可达的等待任务。这里的 goroutine 最终都被显式释放,实验没有故意制造不可退出的后台任务。
把阅读变成开发入口
对应用排查,我现在会先确认增长的是活跃 goroutine、存活堆、可扫描区域还是尚未归还的空闲页。遇到“GC 很忙”,再把分配速率、存活对象图、assist、STW 与调度延迟放到同一时间线上。仅看到 heap 高,就提高 GOGC 或强制 GC,都可能把问题移到另一种成本上。
goroutine 的创建应有对应的退出条件:channel 等待、网络等待和后台循环怎样被取消,谁负责 close 或通知,谁负责等待结束。只有停止继续持有对象的任务,才可能让 GC 回收相应数据。对象布局也应结合 profile 判断;本次 bytes/nodes 实验展示了指针布局的影响,但没有证明将所有业务对象改成连续数组就一定划算。
若进一步修改 runtime,我会从一个明确的入口与不变量开始,再选择已有测试。例如研究 syscall 交接,应先核对 _Gsyscall、P 关系和退出握手;研究 Green Tea 应检查 marks/scans 与 span 所有权;研究清扫应检查 sweep generation 和缓存状态。这些修改可能出现“偶尔漏标”或并发状态错误,编译通过、一个小程序跑完都不足以证明正确。
下面是后续可用的验证命令,本次没有执行它们,也没有宣称完成 runtime 开发或上游测试:
1cd /home/lism/work/go/src
2../bin/go test runtime -run 'Test.*(GC|Syscall|Chan)' -count=1
3../bin/go test runtime/metrics -count=1
测试名筛选需要先核对当前版本实际覆盖了哪些测试;底层修改后还需用源码树的构建与测试流程生成匹配的工具链,扩大并发、平台及压力验证。仅对比这里的小负载,不足以替代 runtime 的正确性验证。
这篇笔记提供的实验入口是有限的:堆对象扫描、一个阻塞管道 syscall、以及有限数量的等待 goroutine。生产服务的尾延迟、容器限制、cgo 分配、netpoll 和真实对象图都需要各自的证据。继续调优时应保留这些条件,而不是把本次单次毫秒值变成配置经验。
源码和复现材料
完整实验代码、运行说明与源码哈希、bytes 结果、nodes GOGC=50、nodes GOGC=100、nodes GOGC=200、goroutine 对象保留结果 和 syscall 输出 随文章保存。采样与 JSON 编码本身会产生少量分配,MemStats 与 metrics.Read 也不是联合原子快照,不能把尾数视为绝对精度。
复查源码时可沿以下入口继续,链接均固定在 go1.26.2:
| 要核对的问题 | 源码入口 |
|---|---|
| 小对象分配与 assist 记账 | malloc.go,mallocgc、deductAssistCredit |
| per-P 缓存与补充 span | mcache.go,refill |
| 调度与 syscall 交接 | proc.go,findRunnable、reentersyscall、retake、exitsyscall |
| GC 阶段和完成判定 | mgc.go,gcStart、gcMarkDone、gcMarkTermination |
| 根扫描与分配者协助 | mgcmark.go,markroot、scanstack、gcAssistAlloc |
| Green Tea 的 span 扫描 | mgcmark_greenteagc.go,spanInlineMarkBits、scanSpan |
| 目标、启动阈值与内存限制 | mgcpacer.go,commit、trigger、memoryLimitHeapGoal |
| 对象 slot 清扫与页归还 | mgcsweep.go、mgcscavenge.go |
写回博客前,本机重新编译并运行了上述三类实验,读取了逃逸分析输出与 syscall trace;文章的 Hugo 构建和渲染检查只验证文稿与资源能够展示,不等价于通过 Go runtime 的完整测试。